

Spracheingabe wirkt oft mühelos: Man spricht, das System reagiert. In der Praxis ist die Umwandlung von rohen Mikrofon-Daten in zuverlässige, intentionsbewusste Aktionen eines der komplexeren Probleme im Echtzeit-Interaktionsdesign – besonders auf Standalone-Headsets, wo Latenz, Performance und Speicherbeschränkungen gnadenlos sind.
Dieser Beitrag führt durch die Architektur eines Speech-to-Action-Systems, das wir in Unity gebaut haben. Es geht nicht um einen einzelnen Speech-to-Text-API-Aufruf, sondern um die Schichten darum herum: Wie Sprache überhaupt erkannt wird, wie Absicht von Hintergrundgeräuschen getrennt wird und wie unvollkommene Erkennungsergebnisse in etwas verwandelt werden, auf das Nutzer sich verlassen können.
Das Ziel war ein System, das sich natürlich anfühlt, offline funktioniert, bei Ausfällen elegant degradiert und beim Debugging verständlich bleibt, wenn etwas schiefgeht.
Über die Idee
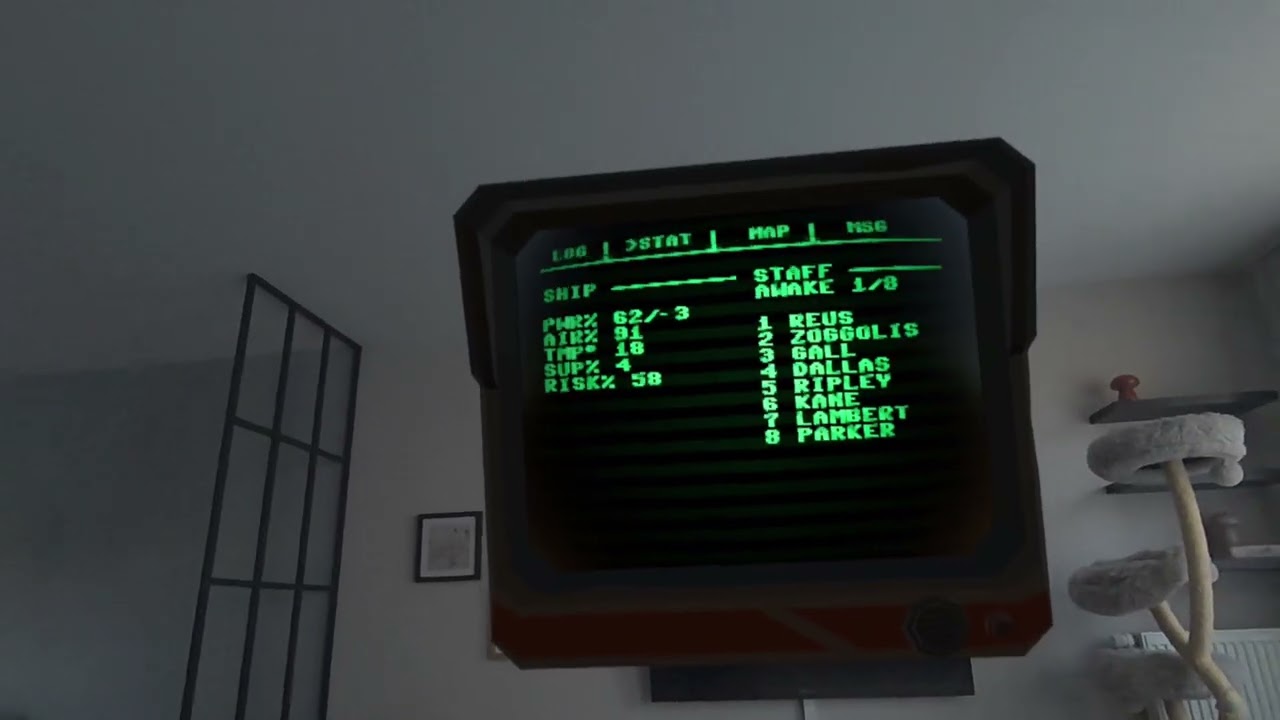
Das Sprachbefehlsystem wurde für ein spezifisches Mixed-Reality-Spiel gebaut, in dem Spieler eine Diorama-ähnliche Raumschiffszene ohne traditionelle Steuerung betrachten. Nur Sprachbefehle funktionieren.
Spieler übernehmen die Rolle der KI des Schiffs und treffen auf ein Besatzungsmitglied, das aus dem Kryoschlaf an Bord eines ruhenden Tiefraum-Schiffs erwacht. Das Gameplay ist asymmetrisch: Spieler handeln nie direkt, sondern manipulieren Schiffsysteme wie Heizung, Türen und Vorräte über Sprache. Das Besatzungsmitglied reagiert auf diese Umweltveränderungen: Eine geöffnete Tür führt zu Erkundung, während ein ungeheizter Raum schließlich zum Tod führt.
Das schafft strategische Spannung, während Spieler Energie, Temperatur und Zugang ausbalancieren, um sowohl Überleben als auch Fortschritt zu gewährleisten – mit Sprache als einziger Schnittstelle und Besatzungsverhalten als Feedback-Mechanismus.
Hier ist ein Video, das die gesamte Erfahrung beschreibt. Das Video ist nur auf Englisch verfügbar.
Wenn du auf den Play-Button klickst, wird der YouTube-Player eingebettet und Cookies von Drittanbietern gesetzt und Daten von YouTube gesammelt.
Von Audio zu Intent
Von außen betrachtet lässt sich die Pipeline schnell zusammenfassen: Mikrofoneingabe geht rein, Aktionen kommen raus. Die Komplexität versteckt sich in allem dazwischen. Rohes Audio ist kontinuierlich, verrauscht und meist irrelevant. Befehle sind spärlich, intentional und müssen schnell interpretiert werden.
Um das System reaktionsschnell zu halten, ist der Ablauf in einige konservative Stufen aufgeteilt:
- Erkennen, ob überhaupt Sprache vorhanden ist (VAD)
- Erkennen und Transkribieren der Sprache (Speech-to-Text)
- Entscheiden, ob der Nutzer das System anspricht (Wake Word)
- Intent interpretieren und auf Szenenaktionen abbilden (Parsing + Matching)
Teure Operationen finden nur statt, wenn günstigere Checks darauf hindeuten, dass es sich lohnt.
Spracherkennung vs. Transkription
In diesem Projekt hilft es, zwei Dinge zu trennen, die oft unter "Active Speech Recognition" (kurz: "ASR") zusammengefasst werden.
Erstens gibt es Spracherkennung im wörtlichen Sinne: Erkennen, ob ein Nutzer überhaupt spricht, und das Aufteilen des Audiostreams in sinnvolle Sprachsegmente. Zweitens gibt es Transkription: Die Umwandlung dieser erkannten Sprachsegmente in Text. Beide Teile müssen mit Akzenten, Tempo, unvollständigen Wörtern, Hintergrundgeräuschen und der Tatsache umgehen, dass gesprochene Sprache selten sauberen grammatischen Grenzen folgt.
Transkription wird als Streaming-Prozess behandelt. Teilweise Ergebnisse kommen an, während der Nutzer noch spricht, und ein finales Ergebnis wird ausgegeben, sobald die Sprache endet. Teilweise Ergebnisse sind schnell und verrauscht; finale Ergebnisse sind langsamer, aber zuverlässiger. Beide sind nützlich.
Teiltranskription wird hauptsächlich für Feedback und Wake-Word-Erkennung verwendet. Finale Transkription ist das, was tatsächlich die Befehlsausführung antreibt.
Warum Voice Activity Detection zuerst kommt
Kontinuierliche Spracherkennung auf roher Mikrofoneingabe auszuführen ist verschwenderisch. Die meiste Zeit spricht niemand. Selbst wenn jemand spricht, könnte es nicht an das System gerichtet sein.
Voice Activity Detection (VAD) fungiert als erste Barriere. Sie betrachtet Audio und beantwortet eine enge Frage: Ist gerade menschliche Sprache vorhanden?
Die primäre Implementierung nutzt einen kleinen neuralen Netzwerk-basierten VAD (TEN-VAD). Er ist speziell darauf trainiert, Sprache von Nicht-Sprache zu unterscheiden, auch bei Hintergrundgeräuschen. Statt nur auf Lautstärke zu reagieren, erkennt er sprachähnliche Muster, was falsche Aktivierungen dramatisch reduziert.
Wir nutzten das "unity-asr" Projekt auf GitHub als Ausgangspunkt. Dieses Repository implementiert ASR basierend auf TEN-VAD und Speech-to-Text mit Vosk und Wav2Vec2. Allerdings erlebten wir mehrere Probleme, als wir dies direkt auf einem Standalone-Headset wie dem Meta Quest 3 ausprobierten. Z.B. generierte die ursprüngliche Bibliothek, die im ASR Unity-Projekt enthalten war, Page-Alignment-Warnungen und verursachte Crashes auf Meta Quest, daher wechselten wir zur aktualisierten libten_vad.so gemäß diesem Commit.
Um dies und andere unerwartete Probleme zu mildern, enthält das System immer einen Fallback.
Wenn TEN‑VAD nicht verfügbar ist oder sich falsch verhält, schaltet es automatisch auf einen einfachen energiebasierten Detektor um, der Signalstärke über RMS (Root Mean Square, ein einfaches Maß für durchschnittliche Signalenergie über die Zeit) misst. Dieser Fallback ist weit weniger genau, funktioniert aber überall und stellt sicher, dass das System nie komplett ausfällt.
In beiden Varianten ist die Ausgabe absichtlich klein: eine Sprache / keine-Sprache-Entscheidung plus ein Konfidenzwert, den man schwellen kann. Wenn nicht, bleibt der Rest der Pipeline inaktiv.
In der Praxis ist der Kompromiss einfach:
- TEN-VAD ist besser darin, "laut, aber keine Sprache"-Geräusche zu ignorieren
- energiebasierte Erkennung ist schwerer abzusichern, aber nahezu unmöglich zu brechen
Offline Speech-to-Text mit Vosk
Für die Speech-to-Text-Transkription nutzt das System Vosk, eine Offline-Speech-to-Text-Engine. Diese Entscheidung wurde hauptsächlich von Beschränkungen getrieben, die in Standalone-Headsets und ähnlichen eingebetteten Kontexten üblich sind: unzuverlässige Konnektivität, enge Latenzbudgets und ein starker Wunsch, Audiodaten auf dem Gerät zu behalten. Ein weiterer praktischer Faktor ist die Modellgröße: In Tests kommen sowohl das englische als auch das deutsche Sprachmodell bei jeweils etwa 50 MB, was sie einfach zu versenden, zu laden und zu iterieren macht, selbst in speicherbeschränkten Umgebungen.
Offline-Erkennung entfernt eine ganze Klasse von Fehlermodi. Es gibt keine Netzwerk-Roundtrips, keine API-Quoten und keine stillen Ausfälle. Latenz ist vorhersagbar, und Datenschutzbedenken sind einfacher zu handhaben.
Die Referenzimplementierung führte alle Arbeiten auf dem Hauptthread aus, was die Anwendung auf einem Meta Quest 3 beeinträchtigte. Daher läuft Vosk in unserer Unity-Implementierung auf einem Hintergrund-Worker-Thread. Audioaufnahme und Zustandsverwaltung bleiben auf dem Hauptthread, während Erkennung asynchron stattfindet. Ergebnisse werden über threadsichere Queues zurückgegeben, wodurch Framezeiten auch während längerer Äußerungen stabil bleiben.
Wake Words und intentionale Interaktion
Eine der wichtigsten Designentscheidungen ist, dass das System nicht alle Sprache als Befehle behandelt. Ein Wake Word definiert Intent.
Während ASR läuft, werden Teiltranskriptionsergebnisse auf konfigurierte Wake Words gescannt. Wenn eines erkannt wird, schaltet das System in einen Listening-Modus. Erst dann beginnt es, Sprache als Befehl zu akkumulieren.
Jeder Text vor dem Wake Word wird verworfen. Alles danach wird Teil des Befehls. Aus Nutzersicht fühlt sich das natürlich an: Wake Word sagen, dann normal sprechen.
Der Listening-Modus ist zeitgebunden. Wenn nach einem konfigurierbaren Intervall keine weitere Sprache erkannt wird, nimmt das System an, dass der Befehl vollständig ist und geht zur Interpretation über. Das vermeidet unangenehme "Bist du noch da?"-Zustände und hält die Interaktion flott.
Text in Befehle verwandeln
Sobald eine finale Transkription verfügbar ist, parst das System sie in Struktur. Befehle folgen einem einfachen mentalen Modell: eine Aktion, ein optionales Ziel und ein optionales Argument.
- "Tür aktivieren."
- "System drei pingen."
- "Neustart."
Der Parser normalisiert den Text, teilt ihn in Tokens auf und weist Rollen basierend auf Position und Typ zu. Zahlen werden wenn möglich als Argumente interpretiert. Alles andere wird gegen bekannte Verben und Objekte aufgelöst.
Diese Einfachheit ist beabsichtigt. Sprachbefehle sollten vorhersagbar zum Debuggen und einfach zu erweitern sein, ohne eine vollständige natürliche Sprachgrammatik einzuführen.
Umgang mit unvollkommener Erkennung
Spracherkennung macht Fehler. Um dies auszugleichen, nutzt das System Fuzzy Matching basierend auf Levenshtein-Distanz. Statt exakte Matches zu verlangen, misst es, wie viele Einzelzeichen-Änderungen das erkannte Wort von bekannten Befehlen oder Objektnamen trennen.
Schwellenwerte skalieren mit Wortlänge. Kurze Wörter werden strenger behandelt, um versehentliche Matches zu vermeiden. Längere Wörter können mehr Fehler tolerieren, ohne mehrdeutig zu werden.
Das erlaubt es, Text wie "show lock" korrekt zu "show log" aufzulösen, ohne dass der Nutzer jemals bemerkt, dass die Erkennung unvollkommen war.
Exakte Matches werden immer bevorzugt. Fuzzy Matching aktiviert sich nur, wenn nötig, wodurch Performance vorhersagbar bleibt und überraschende Interpretationen vermieden werden.
Aliase und natürliche Sprachflexibilität
Menschen nutzen selten konsistent dieselben Wörter. Ein Nutzer sagt "Tür", ein anderer sagt "Eingang", ein dritter sagt "Tor". Alle meinen dasselbe.
Das System unterstützt Aliase auf jeder Ebene: Verben, Objekte und sogar Parameterwerte. Alle Aliase lösen intern auf einen einzigen kanonischen Schlüssel auf, sodass Ausführungslogik sauber und deterministisch bleibt.
Fuzzy Matching gilt auch für Aliase, was bedeutet, dass Erkennungsfehler und Vokabularunterschiede vom selben Mechanismus behandelt werden.
Das Ergebnis ist ein System, das sich flexibel zum Sprechen anfühlt, aber unter der Haube starr und vorhersagbar ist.
Zustände, Fehler und Degradation
Intern bewegt sich das System durch eine kleine Menge expliziter Zustände: idle, speaking, listening und processing. Jeder Zustand hat klare Verantwortlichkeiten und Austrittsbedingungen.
Fehler werden als Teil des normalen Betriebs behandelt. Mehrdeutige Ziele werden dem Nutzer zurückgemeldet, statt geraten zu werden. Unbekannte Befehle crashen die Pipeline nicht; sie lassen das System einfach weiter zuhören.
Wenn VAD ausfällt, aktiviert sich der Fallback. Wenn ASR einen Fehler erlebt, wird er geloggt und isoliert. Das Ziel ist immer dasselbe: Das System reaktionsschnell halten, auch wenn einzelne Komponenten sich falsch verhalten.
Abschließende Gedanken
Was Sprachinteraktion schwierig macht, ist nicht nur Spracherkennung, sondern alles darum herum: Wissen, wann man zuhören soll, wann man ignorieren soll und wie man sich elegant erholt, wenn Dinge unklar sind.
Durch das Schichten günstiger Erkennung vor teurer Verarbeitung, die Nutzung von Offline-Erkennung und das Umarmen von Fuzzy Matching statt dagegen anzukämpfen, fühlt sich dieses System am Ende weit zuverlässiger an, als seine einzelnen Komponenten vermuten lassen würden.
Am wichtigsten ist, dass es verständlich bleibt. Wenn etwas schiefgeht, gibt es einen klaren Ort zum Nachschauen. Und das ist genauso wichtig wie Erkennungsgenauigkeit, wenn man Echtzeit-Interaktionssysteme baut!
Arbeite mit uns
Sprach-Interaktion ist nicht nur für Spiele interessant. Sie kann wirklich gut für Training, Simulationen, Barrierefreiheit oder jede Situation funktionieren, in der freihändige Interaktion Sinn macht.
Wenn du an so etwas arbeitest oder eine Idee hast, wo Sprache oder XR nützlich sein könnte, melde dich gerne. Wir sind immer glücklich, Ideen zu erkunden und gemeinsam Prototypen zu bauen.