

La entrada de voz a menudo parece sin esfuerzo: hablas, el sistema reacciona. En la práctica, convertir datos de micrófono en bruto en acciones confiables y conscientes de la intención es uno de los problemas más complicados en el diseño de interacción en tiempo real, especialmente en cascos independientes, donde la latencia, el rendimiento y las restricciones de memoria son implacables.
Esta publicación recorre la arquitectura de un sistema de voz a acción que construimos en Unity. No se trata de una sola llamada API de voz a texto, sino de las capas a su alrededor: cómo se detecta el habla en primer lugar, cómo se separa la intención del parloteo de fondo, y cómo los resultados de reconocimiento imperfectos se convierten en algo en lo que los usuarios aún pueden confiar.
El objetivo era un sistema que se sienta natural, funcione offline, degrade con gracia cuando las partes fallan, y permanezca comprensible para depurar cuando algo sale mal.
Sobre la Idea
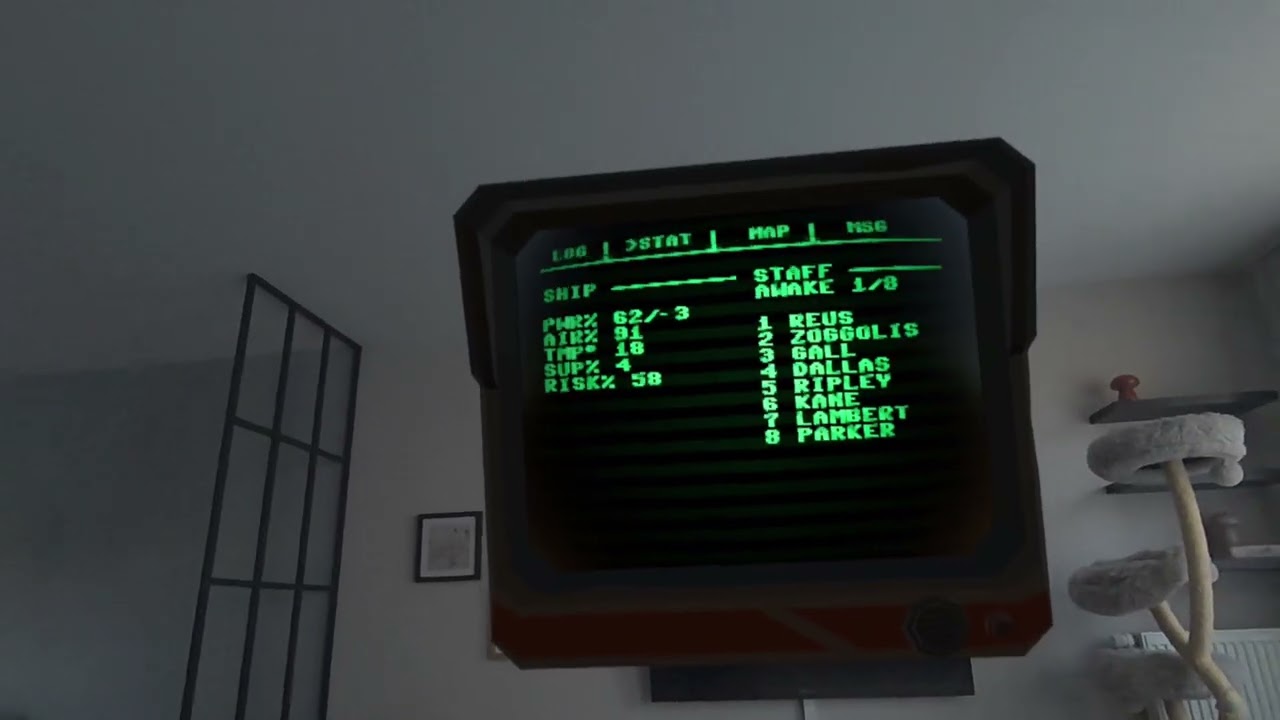
El sistema de comandos de voz se construyó para un juego específico de Realidad Mixta donde los jugadores ven una escena de nave espacial tipo diorama sin controles tradicionales. Solo funcionan los comandos de voz.
Los jugadores toman el papel de la IA de la nave y se encuentran con un miembro de la tripulación que emerge del sueño criogénico a bordo de una nave espacial profunda en hibernación. El gameplay es asimétrico: los jugadores nunca actúan directamente, sino que manipulan sistemas de la nave como calefacción, puertas y suministros a través de la voz. El miembro de la tripulación responde a estos cambios ambientales: abrir una puerta provoca exploración, mientras que una habitación sin calefacción eventualmente lleva a la muerte.
Esto crea tensión estratégica mientras los jugadores equilibran energía, temperatura y acceso para asegurar tanto la supervivencia como el progreso, con la voz como la única interfaz y el comportamiento de la tripulación como el mecanismo de retroalimentación.
Aquí hay un video que describe toda la experiencia. El video solo está disponible en inglés.
Al hacer clic en el botón de reproducción, se incrustará el reproductor de YouTube y se pueden establecer cookies de terceros y recopilar datos de YouTube.
De Audio a Intención
Visto desde fuera, la pipeline se puede resumir rápidamente: entra la entrada del micrófono, salen las acciones. La complejidad se esconde en todo lo que hay en medio. El audio en bruto es continuo, ruidoso y en su mayoría irrelevante. Los comandos son escasos, intencionales y necesitan ser interpretados rápidamente.
Para mantener el sistema responsivo, el flujo se divide en algunas etapas conservadoras:
- detectar si hay habla en absoluto (VAD)
- reconocer y transcribir el habla (voz a texto)
- decidir si el usuario se está dirigiendo al sistema (palabra de activación)
- interpretar la intención y mapearla a acciones de escena (parsing + matching)
El trabajo costoso solo ocurre cuando las verificaciones más baratas sugieren que vale la pena hacerlo.
Reconocimiento de Voz vs. Transcripción
En este proyecto, ayuda separar dos cosas que a menudo se agrupan bajo "Reconocimiento de Voz Activo" (abreviado: "ASR").
Primero, está el reconocimiento de voz en el sentido literal: detectar si un usuario está hablando en absoluto, y dividir el flujo de audio en segmentos de habla significativos. Segundo, está la transcripción: convertir esos segmentos de habla detectados en texto. Ambas partes tienen que lidiar con acentos, ritmo, palabras incompletas, ruido de fondo, y el hecho de que el lenguaje hablado rara vez sigue límites gramaticales limpios.
La transcripción se trata como un proceso de streaming. Los resultados parciales llegan mientras el usuario aún está hablando, y se emite un resultado final una vez que el habla termina. Los resultados parciales son rápidos y ruidosos; los resultados finales son más lentos pero más confiables. Ambos son útiles.
La transcripción parcial se usa principalmente para retroalimentación y detección de palabras de activación. La transcripción final es lo que realmente impulsa la ejecución de comandos.
Por Qué la Detección de Actividad de Voz Viene Primero
Ejecutar reconocimiento de voz continuamente en la entrada del micrófono en bruto es derrochador. La mayor parte del tiempo, nadie está hablando. Incluso cuando lo están, podría no estar dirigido al sistema.
Detección de Actividad de Voz (VAD) actúa como la primera puerta. Mira el audio y responde una pregunta estrecha: ¿hay habla humana ahora mismo?
La implementación principal usa un VAD pequeño basado en red neuronal (TEN-VAD). Está entrenado específicamente para distinguir habla de no habla, incluso cuando hay ruido de fondo presente. En lugar de reaccionar solo al volumen, reconoce patrones similares al habla, lo que reduce dramáticamente las activaciones falsas.
Usamos el proyecto "unity-asr" en GitHub como punto de partida. Este repositorio implementa ASR basado en TEN-VAD y voz a texto usando Vosk y Wav2Vec2. Sin embargo, experimentamos varios problemas al intentar esto directamente en un casco independiente como el Meta Quest 3. Por ejemplo, la biblioteca original incluida en el proyecto ASR Unity generó advertencias de alineación de página y causó fallos en Meta Quest, por lo tanto cambiamos a la libten_vad.so actualizada según este commit.
Para mitigar esto y otros problemas inesperados, el sistema siempre incluye un respaldo.
Cuando TEN‑VAD no está disponible o se comporta mal, cambia automáticamente a un detector simple basado en energía que mide la potencia de la señal vía RMS (Root Mean Square, una medida simple de energía promedio de señal a lo largo del tiempo). Este respaldo es mucho menos preciso, pero funciona en todas partes y asegura que el sistema nunca se rompa completamente.
En ambas variantes, la salida es intencionalmente pequeña: una decisión de habla / no habla más una puntuación de confianza que puedes umbralizar. Si no, el resto de la pipeline permanece inactiva.
En la práctica, el compromiso es simple:
- TEN-VAD es mejor para ignorar ruido "fuerte pero no habla"
- la detección basada en energía es más difícil de proteger, pero casi imposible de romper
Voz a Texto Offline con Vosk
Para la transcripción de voz a texto, el sistema usa Vosk, un motor de voz a texto offline. Esta decisión fue impulsada en gran parte por restricciones comunes en cascos independientes y contextos embebidos similares: conectividad poco confiable, presupuestos de latencia ajustados, y un fuerte deseo de mantener los datos de audio en el dispositivo. Otro factor práctico es el tamaño del modelo: en pruebas, tanto el modelo de idioma inglés como el alemán vienen en aproximadamente 50 MB cada uno, lo que los hace fáciles de enviar, cargar e iterar incluso en entornos con restricciones de memoria.
El reconocimiento offline elimina toda una clase de modos de fallo. No hay viajes de ida y vuelta de red, no hay cuotas de API, y no hay interrupciones silenciosas. La latencia es predecible, y las preocupaciones de privacidad son más fáciles de razonar.
La implementación de referencia hizo todo el trabajo en el hilo principal, lo que impactó la aplicación en un Meta Quest 3. Por lo tanto, en nuestra implementación de Unity, Vosk se ejecuta en un hilo de trabajo en segundo plano. La captura de audio y la gestión de estado permanecen en el hilo principal, mientras que el reconocimiento ocurre de forma asíncrona. Los resultados se pasan de vuelta a través de colas seguras para hilos, manteniendo los tiempos de frame estables incluso durante expresiones más largas.
Palabras de Activación e Interacción Intencional
Una de las decisiones de diseño más importantes es que el sistema no trata todo el habla como comandos. Una palabra de activación define la intención.
Mientras ASR está ejecutándose, los resultados de transcripción parcial se escanean en busca de palabras de activación configuradas. Cuando se detecta una, el sistema cambia a un modo de escucha. Solo entonces comienza a acumular habla en un comando.
Cualquier texto antes de la palabra de activación se descarta. Cualquier cosa después se convierte en parte del comando. Desde la perspectiva del usuario, esto se siente natural: di la palabra de activación, luego habla normalmente.
El modo de escucha está limitado por tiempo. Si no se detecta más habla después de un intervalo configurable, el sistema asume que el comando está completo y pasa a la interpretación. Esto evita estados incómodos de "¿sigues ahí?" y mantiene la interacción ágil.
Convertir Texto en Comandos
Una vez que una transcripción final está disponible, el sistema la analiza en estructura. Los comandos siguen un modelo mental simple: una acción, un objetivo opcional y un argumento opcional.
- "Activar puerta."
- "Hacer ping al sistema tres."
- "Reiniciar."
El analizador normaliza el texto, lo divide en tokens, y asigna roles basados en posición y tipo. Los números se interpretan como argumentos cuando es posible. Todo lo demás se resuelve contra verbos y objetos conocidos.
Esta simplicidad es intencional. Los comandos de voz deberían ser predecibles para depurar y fáciles de extender sin introducir una gramática de lenguaje natural completa.
Lidiar con Reconocimiento Imperfecto
El reconocimiento de voz comete errores. Para compensar, el sistema usa coincidencia difusa basada en distancia de Levenshtein. En lugar de requerir coincidencias exactas, mide cuántas ediciones de un solo carácter separan la palabra reconocida de comandos conocidos o nombres de objetos.
Los umbrales escalan con la longitud de la palabra. Las palabras cortas se tratan más estrictamente para evitar coincidencias accidentales. Las palabras más largas pueden tolerar más errores sin volverse ambiguas.
Esto permite que texto como "show lock" se resuelva correctamente a "show log" sin que el usuario note nunca que el reconocimiento fue imperfecto.
Las coincidencias exactas siempre se prefieren. La coincidencia difusa solo se activa cuando es necesario, manteniendo el rendimiento predecible y evitando interpretaciones sorprendentes.
Alias y Flexibilidad de Lenguaje Natural
Las personas rara vez usan las mismas palabras consistentemente. Un usuario dice "puerta", otro dice "entrada", un tercero dice "portal". Todos significan lo mismo.
El sistema admite alias en cada nivel: verbos, objetos, e incluso valores de parámetros. Todos los alias se resuelven a una sola clave canónica internamente, por lo que la lógica de ejecución permanece limpia y determinista.
La coincidencia difusa también se aplica a los alias, lo que significa que los errores de reconocimiento y las diferencias de vocabulario se manejan con el mismo mecanismo.
El resultado es un sistema que se siente flexible para hablar, pero rígido y predecible bajo el capó.
Estados, Errores y Degradación
Internamente, el sistema se mueve a través de un pequeño conjunto de estados explícitos: idle, speaking, listening y processing. Cada estado tiene responsabilidades claras y condiciones de salida.
Los errores se tratan como parte de la operación normal. Los objetivos ambiguos se reportan de vuelta al usuario en lugar de adivinarse. Los comandos desconocidos no crashean la pipeline; simplemente mantienen el sistema escuchando.
Si VAD falla, el respaldo se activa. Si ASR encuentra un error, se registra y se aísla. El objetivo es siempre el mismo: mantener el sistema responsivo, incluso cuando los componentes individuales se comportan mal.
Pensamientos Finales
Lo que hace difícil la interacción por voz no es solo el reconocimiento de voz, sino todo lo que lo rodea: saber cuándo escuchar, cuándo ignorar, y cómo recuperarse con gracia cuando las cosas no están claras.
Al estratificar la detección barata antes del procesamiento costoso, usando reconocimiento offline, y abrazando la coincidencia difusa en lugar de luchar contra ella, este sistema termina sintiéndose mucho más confiable de lo que sus componentes individuales sugerirían.
Lo más importante, permanece comprensible. Cuando algo sale mal, hay un lugar claro donde mirar. ¡Y eso importa tanto como la precisión del reconocimiento cuando estás construyendo sistemas interactivos en tiempo real!
Trabaja con Nosotros
La interacción solo por voz no es solo interesante para juegos. Puede funcionar muy bien para entrenamiento, simulaciones, accesibilidad, o cualquier situación donde la interacción manos libres tenga sentido.
Si estás trabajando en algo así, o tienes una idea donde la voz o XR podría ser útil, no dudes en contactarnos. Siempre estamos felices de explorar ideas y construir prototipos juntos.