

Spraakinvoer lijkt vaak moeiteloos: je spreekt, het systeem reageert. In de praktijk is het omzetten van ruwe microfoondata in betrouwbare, intentiebewuste acties een van de lastigere problemen in realtime interactieontwerp – vooral op standalone headsets, waar latency, performance en geheugenbeperkingen genadeloos zijn.
Deze post loopt door de architectuur van een spraak-naar-actie systeem dat we in Unity hebben gebouwd. Het gaat niet om één enkele spraak-naar-tekst API-call, maar om de lagen eromheen: hoe spraak überhaupt wordt gedetecteerd, hoe intentie wordt gescheiden van achtergrondgeluid, en hoe imperfecte herkenningsresultaten worden omgezet in iets waarop gebruikers nog steeds kunnen vertrouwen.
Het doel was een systeem dat natuurlijk aanvoelt, offline werkt, elegant degradeert wanneer onderdelen falen, en begrijpelijk blijft om te debuggen wanneer iets misgaat.
Over het Idee
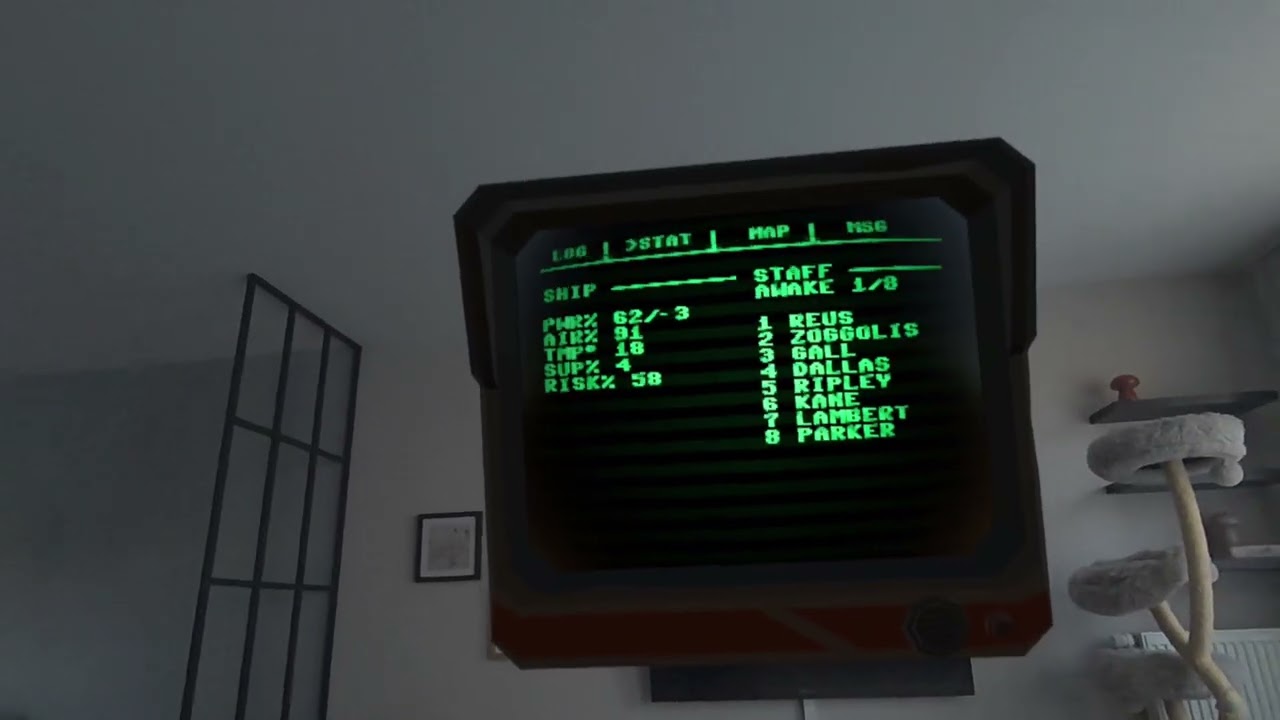
Het spraakcommando-systeem werd gebouwd voor een specifiek Mixed Reality-spel waarbij spelers een diorama-achtige ruimteschipscène bekijken zonder traditionele controls. Alleen spraakcommando's werken.
Spelers nemen de rol aan van de AI van het schip en komen een bemanningslid tegen dat ontwaakt uit cryoslaap aan boord van een slapend diepruimteschip. De gameplay is asymmetrisch: spelers handelen nooit direct, maar manipuleren schipsystemen zoals verwarming, deuren en voorraden via spraak. Het bemanningslid reageert op deze omgevingsveranderingen: een geopende deur leidt tot verkenning, terwijl een ongeverwarmde ruimte uiteindelijk tot de dood leidt.
Dit creëert strategische spanning terwijl spelers energie, temperatuur en toegang balanceren om zowel overleving als vooruitgang te waarborgen, met spraak als de enige interface en bemanningsgedrag als feedbackmechanisme.
Hier is een video die de hele ervaring beschrijft. De video is alleen beschikbaar in het Engels.
Als je op de afspeelknop klikt, wordt de YouTube-speler ingesloten en kunnen cookies van derden worden ingesteld en gegevens van YouTube worden verzameld.
Van Audio naar Intentie
Van buitenaf bekeken kan de pipeline snel worden samengevat: microfooninvoer gaat erin, acties komen eruit. De complexiteit schuilt in alles daartussenin. Ruwe audio is continu, luidruchtig en meestal irrelevant. Commando's zijn schaars, intentioneel en moeten snel worden geïnterpreteerd.
Om het systeem responsief te houden, is de flow opgesplitst in een paar conservatieve stadia:
- detecteren of er überhaupt spraak is (VAD)
- spraak herkennen en transcriberen (spraak-naar-tekst)
- beslissen of de gebruiker het systeem aanspreekt (wake word)
- intentie interpreteren en mappen naar scene-acties (parsing + matching)
Dure operaties gebeuren alleen wanneer goedkopere checks suggereren dat het de moeite waard is.
Spraakherkenning vs. Transcriptie
In dit project helpt het om twee dingen te scheiden die vaak onder "Active Speech Recognition" (kort: "ASR") worden samengevoegd.
Ten eerste is er spraakherkenning in de letterlijke zin: detecteren of een gebruiker überhaupt spreekt, en de audiostroom opdelen in betekenisvolle spraaksegmenten. Ten tweede is er transcriptie: die gedetecteerde spraaksegmenten omzetten in tekst. Beide delen moeten omgaan met accenten, tempo, onvolledige woorden, achtergrondgeluid, en het feit dat gesproken taal zelden nette grammaticale grenzen volgt.
Transcriptie wordt behandeld als een streamingproces. Gedeeltelijke resultaten arriveren terwijl de gebruiker nog spreekt, en een eindresultaat wordt uitgezonden zodra de spraak eindigt. Gedeeltelijke resultaten zijn snel en luidruchtig; eindresultaten zijn langzamer maar betrouwbaarder. Beide zijn nuttig.
Gedeeltelijke transcriptie wordt voornamelijk gebruikt voor feedback en wake-word-detectie. Eindtranscriptie is wat daadwerkelijk commando-uitvoering aanstuurt.
Waarom Voice Activity Detection Eerst Komt
Spraakherkenning continu uitvoeren op ruwe microfooninvoer is verspillend. Meestal spreekt niemand. Zelfs wanneer ze dat wel doen, is het misschien niet gericht aan het systeem.
Voice Activity Detection (VAD) fungeert als de eerste poort. Het bekijkt audio en beantwoordt een smalle vraag: is er nu menselijke spraak?
De primaire implementatie gebruikt een kleine neural network-gebaseerde VAD (TEN-VAD). Het is specifiek getraind om spraak van niet-spraak te onderscheiden, zelfs wanneer achtergrondgeluid aanwezig is. In plaats van alleen op volume te reageren, herkent het spraakachtige patronen, wat valse activaties drastisch vermindert.
We gebruikten het "unity-asr" project op GitHub als uitgangspunt. Deze repository implementeert ASR gebaseerd op TEN-VAD en spraak-naar-tekst met Vosk en Wav2Vec2. We ondervonden echter verschillende problemen bij het direct proberen op een standalone headset zoals de Meta Quest 3. Bijvoorbeeld, de originele bibliotheek opgenomen in het ASR Unity-project genereerde page alignment-waarschuwingen en veroorzaakte crashes op Meta Quest, daarom schakelden we over naar de bijgewerkte libten_vad.so volgens deze commit.
Om dit en andere onverwachte problemen te verzachten, bevat het systeem altijd een fallback.
Wanneer TEN‑VAD niet beschikbaar is of zich misdraagt, schakelt het automatisch over naar een eenvoudige energiegebaseerde detector die signaalsterkte meet via RMS (Root Mean Square, een eenvoudige maat voor gemiddelde signaalenergie over tijd). Deze fallback is veel minder nauwkeurig, maar werkt overal en zorgt ervoor dat het systeem nooit volledig breekt.
In beide varianten is de output opzettelijk klein: een spraak / geen-spraak beslissing plus een vertrouwensscore die je kunt drempelen. Zo niet, blijft de rest van de pipeline inactief.
In de praktijk is de afweging eenvoudig:
- TEN-VAD is beter in het negeren van "luid maar geen spraak" geluid
- energiegebaseerde detectie is moeilijker foolproof te maken, maar bijna onmogelijk te breken
Offline Spraak-naar-Tekst met Vosk
Voor spraak-naar-tekst transcriptie gebruikt het systeem Vosk, een offline spraak-naar-tekst engine. Deze beslissing werd grotendeels gedreven door beperkingen die gebruikelijk zijn in standalone headsets en vergelijkbare embedded contexten: onbetrouwbare connectiviteit, strakke latency-budgets, en een sterk verlangen om audiodata op het apparaat te houden. Een andere praktische factor is modelgrootte: in tests komen zowel het Engelse als het Duitse taalmodel op ongeveer 50 MB elk, wat ze gemakkelijk te verzenden, laden en itereren maakt, zelfs in geheugenbeperkte omgevingen.
Offline herkenning verwijdert een hele klasse van faalmodi. Er zijn geen netwerk round trips, geen API-quota's, en geen stille uitval. Latency is voorspelbaar, en privacyzorgen zijn eenvoudiger te beredeneren.
De referentie-implementatie deed al het werk op de main thread, wat de applicatie op een Meta Quest 3 beïnvloedde. Daarom draait Vosk in onze Unity-implementatie op een achtergrond worker thread. Audio-opname en state management blijven op de main thread, terwijl herkenning asynchroon plaatsvindt. Resultaten worden teruggegeven via thread-safe queues, waardoor frame-tijden stabiel blijven, zelfs tijdens langere uitingen.
Wake Words en Intentionele Interactie
Een van de belangrijkste ontwerpbeslissingen is dat het systeem niet alle spraak als commando's behandelt. Een wake word definieert intentie.
Terwijl ASR draait, worden gedeeltelijke transcriptieresultaten gescand op geconfigureerde wake words. Wanneer er één wordt gedetecteerd, schakelt het systeem naar een luistermodus. Pas dan begint het spraak te accumuleren in een commando.
Elke tekst vóór het wake word wordt weggegooid. Alles erna wordt onderdeel van het commando. Vanuit gebruikersperspectief voelt dit natuurlijk aan: zeg het wake word, spreek dan normaal.
De luistermodus is tijdgebonden. Als er na een configureerbaar interval geen verdere spraak wordt gedetecteerd, neemt het systeem aan dat het commando compleet is en gaat over naar interpretatie. Dit vermijdt ongemakkelijke "ben je er nog?"-staten en houdt interactie snappy.
Tekst Omzetten in Commando's
Zodra een eindtranscriptie beschikbaar is, parseert het systeem het in structuur. Commando's volgen een eenvoudig mentaal model: een actie, een optioneel doel, en een optioneel argument.
- "Activeer deur."
- "Ping systeem drie."
- "Herstart."
De parser normaliseert de tekst, splitst het in tokens, en wijst rollen toe op basis van positie en type. Cijfers worden waar mogelijk geïnterpreteerd als argumenten. Al het andere wordt opgelost tegen bekende werkwoorden en objecten.
Deze eenvoud is opzettelijk. Spraakcommando's zouden voorspelbaar moeten zijn om te debuggen en eenvoudig uit te breiden zonder een volledige natuurlijke taalgrammatica te introduceren.
Omgaan met Imperfecte Herkenning
Spraakherkenning maakt fouten. Om dit te compenseren gebruikt het systeem fuzzy matching gebaseerd op Levenshtein-afstand. In plaats van exacte matches te vereisen, meet het hoeveel enkele-teken-bewerkingen het herkende woord scheiden van bekende commando's of objectnamen.
Drempels schalen met woordlengte. Korte woorden worden strenger behandeld om toevallige matches te vermijden. Langere woorden kunnen meer fouten tolereren zonder dubbelzinnig te worden.
Dit maakt het mogelijk dat tekst zoals "show lock" correct wordt opgelost naar "show log" zonder dat de gebruiker ooit merkt dat de herkenning imperfect was.
Exacte matches worden altijd geprefereerd. Fuzzy matching activeert alleen wanneer nodig, waardoor performance voorspelbaar blijft en verrassende interpretaties worden vermeden.
Aliassen en Natuurlijke Taalflexibiliteit
Mensen gebruiken zelden consistent dezelfde woorden. De ene gebruiker zegt "deur", een andere zegt "ingang", een derde zegt "poort". Ze bedoelen allemaal hetzelfde.
Het systeem ondersteunt aliassen op elk niveau: werkwoorden, objecten, en zelfs parameterwaarden. Alle aliassen lossen intern op naar een enkele canonieke sleutel, zodat uitvoeringslogica schoon en deterministisch blijft.
Fuzzy matching geldt ook voor aliassen, wat betekent dat herkenningsfouten en vocabulaireverschillen door hetzelfde mechanisme worden afgehandeld.
Het resultaat is een systeem dat flexibel aanvoelt om tegen te spreken, maar rigide en voorspelbaar onder de motorkap.
Staten, Fouten en Degradatie
Intern beweegt het systeem door een kleine set expliciete staten: idle, speaking, listening en processing. Elke staat heeft duidelijke verantwoordelijkheden en exitcondities.
Fouten worden behandeld als onderdeel van normale operatie. Dubbelzinnige doelen worden teruggerapporteerd aan de gebruiker in plaats van geraden. Onbekende commando's crashen de pipeline niet; ze houden het systeem gewoon luisterend.
Als VAD faalt, activeert de fallback. Als ASR een fout tegenkomt, wordt het gelogd en geïsoleerd. Het doel is altijd hetzelfde: houd het systeem responsief, zelfs wanneer individuele componenten zich misdragen.
Slotgedachten
Wat spraakinteractie moeilijk maakt is niet alleen spraakherkenning, maar alles eromheen: weten wanneer te luisteren, wanneer te negeren, en hoe elegant te herstellen wanneer dingen onduidelijk zijn.
Door goedkope detectie te laagjes vóór dure verwerking, offline herkenning te gebruiken, en fuzzy matching omarmen in plaats van ertegen te vechten, voelt dit systeem uiteindelijk veel betrouwbaarder aan dan zijn individuele componenten zouden suggereren.
Het belangrijkste is dat het begrijpelijk blijft. Wanneer iets misgaat, is er een duidelijke plek om te kijken. En dat is net zo belangrijk als herkenningsnauwkeurigheid wanneer je realtime interactieve systemen bouwt!
Werk met Ons
Spraak-only interactie is niet alleen interessant voor games. Het kan echt goed werken voor training, simulaties, toegankelijkheid, of elke situatie waar handenvrije interactie zinvol is.
Als je aan zoiets werkt, of een idee hebt waar spraak of XR nuttig zou kunnen zijn, neem gerust contact op. We zijn altijd blij om ideeën te verkennen en samen prototypes te bouwen.